Transparent Gateway · Python · asyncio · Redis · проксі · HAProxy
Автоматичний пул проксі для Transparent Gateway: збір, перевірка й ранжування
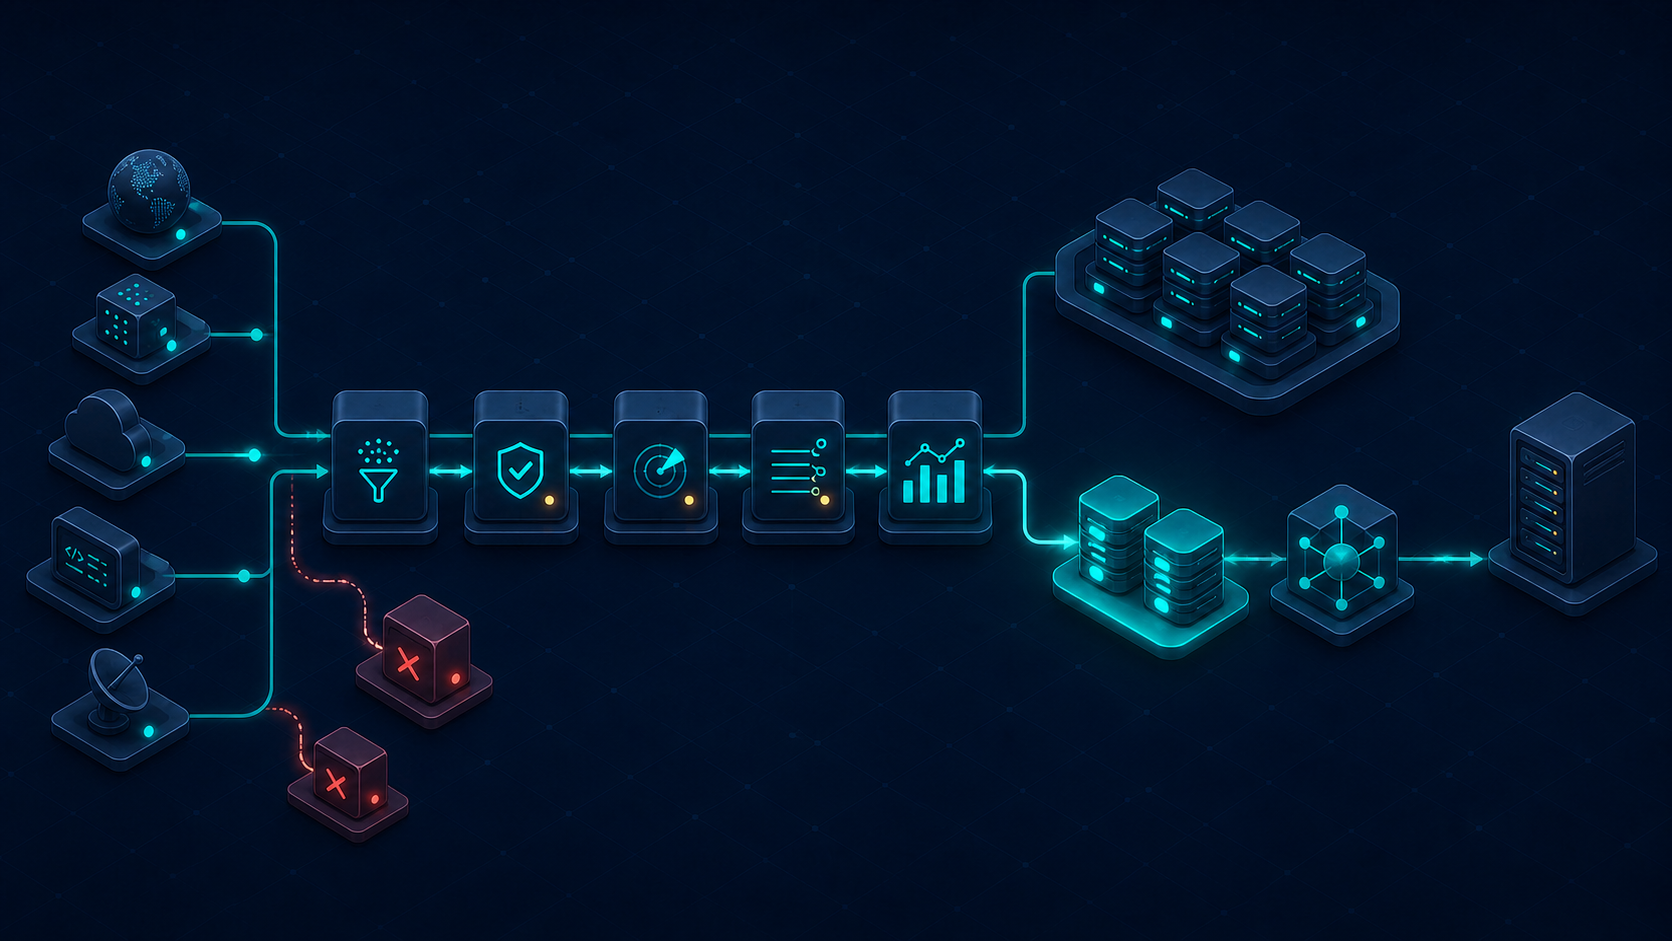
У попередній статті я зібрав і перевірив маршрут звичайного TCP-трафіку: ізольована VM віддає з'єднання на gateway, iptables перенаправляє їх у redsocks, а далі трафік потрапляє в проксі-пул.
Для тесту цього було достатньо. Я підняв вісім LXC-контейнерів, вручну додав їх у конфіг HAProxy, перевірив roundrobin, stick-table і поведінку при падінні одного backend.
Але тестові LXC мають одну дуже зручну властивість: вони нікуди не зникають. Із реальними проксі все навпаки. Сьогодні адреса відповідає за 200 мс, за годину починає віддавати помилки, а завтра її вже немає у списку. Вручну шукати такі адреси, перевіряти й переносити в робочий конфіг я точно не хотів.
Тому наступна частина Transparent Gateway — це конвеєр, який сам збирає кандидатів, відсіює непридатні, ранжує решту й публікує готовий пул.
На папері конвеєр виглядає лінійно. На практиці майже кожна стрілка приховала окреме рішення: де закінчується довіра до джерела, що саме вважати живим проксі, як не зібрати весь пул з однієї мережі та як оновити gateway без розриву трафіку.
Вимоги до автоматичного пулу проксі
До модуля з самого початку було кілька вимог:
- підключати довільну кількість джерел;
- додавати новий формат джерела без змін у fetcher, validator і ranker;
- регулярно оновлювати дані, тому що проксі швидко відмирають;
- перевіряти не лише відкритий порт, а реальне проходження запиту;
- бачити затримку, анонімність і стабільність;
- не складати весь пул з адрес одного провайдера або однієї підмережі;
Є ще одна вимога, яку легко пропустити: джерело не можна вважати довіреним. Навіть якщо JSON завантажився через HTTPS і має правильну структуру, це лише список кандидатів. Кожен із них усе одно має пройти окрему перевірку.
У цій статті під «відкритим джерелом» я маю на увазі feed, умови якого дозволяють автоматичне завантаження та використання. Публічний проксі — чужий вузол із невідомим власником, все передане через такий пул може бути перехоплене власником.
Єдина модель кандидата
Перший локальний глухий кут з’являється ще до перевірки мережі: різні джерела називають ті самі поля по-різному — ip, host, proxy, type, protocol. Якщо протягнути цю різницю далі, validator швидко перетвориться на набір винятків для кожного сайту. Тому проблему треба закрити на вході, а не розмазувати по всьому конвеєру.
Тому на вході я одразу нормалізую запис до ProxyCandidate:
Python-код
@dataclass(frozen=True)
class ProxyCandidate:
    host: str
    port: int
    protocol: str
    source: str
    credential_ref: str | None = None
    metadata: Mapping[str, str] = field(default_factory=dict)
Підтримуються http, https, socks4 і socks5. Логін і пароль у Redis не потрапляють: кандидат зберігає лише credential_ref, а сам секрет лежить в окремому файлі, який читають validator і gateway.
Validator і egress_relay використовують один CredentialStore. HTTP та HTTPS proxy отримують Proxy-Authorization: Basic, SOCKS5 проходить username/password negotiation, а SOCKS4 використовує username як User ID. Secret-файл перечитується за content digest, тому credentials можна ротувати без рестарту. Відсутній credential_ref або неправильний пароль закриває перевірку, а не запускає небезпечний unauthenticated fallback.
Після нормалізації всі наступні модулі працюють з однаковою структурою й не знають, звідки саме приїхав запис.
Fetcher і реєстр джерел
Контракт джерела в поточному коді дуже короткий:
Python-код
class ProxySourceConnector(Protocol):
    name: str

    async def collect(self) -> AsyncIterator[ProxyCandidate]: ...
Кожен connector уміє тільки прочитати свій формат і повернути нормалізовані кандидати. Активація зроблена явно: клас потрібно зареєструвати в коді, дозволити його тип у конфігурації й лише після цього додати конкретне джерело.
Python-код
CONNECTOR_REGISTRY = ConnectorRegistry()
CONNECTOR_REGISTRY.register(
    "jsonl_inventory",
    JsonlInventoryConnector.from_config,
)
CONNECTOR_REGISTRY.register(
    "http_json_feed",
    HttpJsonFeedConnector.from_config,
)
Очевидним скороченням здавався автоматичний пошук connector у каталозі. Але для сервісу, який читає мережеві джерела, це створює іншу проблему: випадковий або підкинутий Python-файл може непомітно ввімкнути новий код. Я повернувся до явного registry: тип реєструється в коді, дозволяється в конфігурації й лише після цього активується.
Зараз у проєкті є два готові connector:
- локальний JSONL inventory для власних або тестових проксі;
- HTTPS JSON feed із необов'язковим Bearer-токеном.
Наприклад, конфіг може виглядати так:
JSON
{
  "allowed_connector_types": [
    "jsonl_inventory",
    "http_json_feed"
  ],
  "active_connectors": [
    {
      "type": "jsonl_inventory",
      "name": "lab-lxc",
      "path": "/inventory/upstreams.jsonl"
    },
    {
      "type": "http_json_feed",
      "name": "provider-api",
      "url": "https://provider.example/api/proxies",
      "token_env": "PROVIDER_API_TOKEN"
    }
  ]
}
Fetcher опитує всі активні connector паралельно. Помилка одного джерела не зупиняє інші, а дублікати прибираються за комбінацією протоколу, хоста, порту й посилання на credentials.
Python-код
collected = await asyncio.gather(
    *(one(connector) for connector in connectors),
    return_exceptions=True,
)

unique[(
    candidate.protocol,
    candidate.host,
    candidate.port,
    candidate.credential_ref,
)] = candidate
Результат циклу — повний сирий snapshot у Redis:
Показати код
proxy_pool:raw:v1
Це ще не пул, через який можна пускати трафік. Тут є лише синтаксично коректні й дедупліковані кандидати.
Як додати джерело з іншим JSON
Generic JSON connector працює лише доти, доки зовнішній feed випадково збігається з внутрішньою моделлю. На реальному JSON-дзеркалі ProxyScrape цей шлях уперся в різні назви полів: джерело віддає ip, port, protocol, asn і latency, тоді як усередині потрібні host та рядкові metadata. Замість винятків у fetcher я додав окремий adapter для цього формату.
Окремий connector зводиться приблизно до такого перетворення:
Python-код
import asyncio
import json
import urllib.request
from typing import AsyncIterator

from .base import ProxyCandidate, parse_candidate


class ProxyScrapeConnector:
    name = "proxyscrape-public"
    url = (
        "https://cdn.jsdelivr.net/gh/proxyscrape/"
        "free-proxy-list@main/proxies/all/data.json"
    )

    def _fetch(self) -> list[dict]:
        request = urllib.request.Request(
            self.url,
            headers={"User-Agent": "transparent-gateway/1"},
        )
        with urllib.request.urlopen(request, timeout=15) as response:
            body = response.read(5 * 1024 * 1024 + 1)
        if len(body) > 5 * 1024 * 1024:
            raise ValueError("feed exceeds 5 MB")
        rows = json.loads(body)
        if not isinstance(rows, list):
            raise ValueError("feed must return a JSON list")
        return rows

    async def collect(self) -> AsyncIterator[ProxyCandidate]:
        rows = await asyncio.to_thread(self._fetch)
        for row in rows:
            yield parse_candidate({
                "host": row["ip"],
                "port": row["port"],
                "protocol": row["protocol"],
                "source": self.name,
                "metadata": {
                    "asn": str(row.get("asn") or ""),
                    "country": str(row.get("country_code") or ""),
                },
            }, self.name)
Після цього лишається зареєструвати тип і додати його до active_connectors. Fetcher, validator і ranker змінювати не потрібно.
Сам feed уже містить власні latency та uptime, але я не використовую їх як остаточну оцінку. Це корисні вхідні metadata, проте рішення про робочий пул має спиратися на вимірювання з мого gateway і до мого контрольного endpoint.
Асинхронна валідація проксі: відкритого порту недостатньо
Наївна перевірка проксі виглядає приблизно так: відкрився TCP-порт — значить живий. На практиці порт може прийняти з'єднання, але не виконати CONNECT, не підтримати заявлений протокол або віддати помилку вже на HTTP-запиті.
Тому валідатор проходить повний шлях:
- встановлює з'єднання з кандидатом;
- виконує реальне узгодження HTTP/HTTPS/SOCKS4/SOCKS5;
- через отриманий тунель звертається до контрольованого echo endpoint;
- перевіряє код відповіді та JSON;
- порівнює побачену адресу з прямою адресою validator;
- шукає витік у
Forwarded,X-Forwarded-For,X-Real-IP,Client-IPта інших заголовках; - вимірює повну затримку операції.
Спочатку validator звертається до echo endpoint напряму й запам'ятовує адресу, яку бачить backend. Потім повторює той самий запит через кожен проксі.
Тут важливо не переплутати дві різні перевірки. У лабораторному стенді ANONYMITY_CHECK_URL вказує на http://10.10.10.2:8000/ — echo endpoint у локальній мережі. Такий тест детерміновано показує, чи проходить запит через HAProxy та контейнери 301–308, чи працює потрібний протокол і чи не витікає пряма адреса validator. Більш детально про нього — у попередній статті. Але він не доводить, що проксі має вихід у публічний інтернет, і не показує адресу, яку побачить зовнішній сайт.
Для разової зовнішньої перевірки можна використати https://httpbin.org/get або https://httpbingo.org/get. На відміну від /ip, endpoint /get повертає не лише поле origin, а й об’єкт headers, який validator використовує для пошуку витоку адреси. Обидва варіанти я перевірив поточним parser:
Показати код
ANONYMITY_CHECK_URL=https://httpbingo.org/get
ipify та ifconfig.me також показують публічну адресу, але використовують поля ip і ip_addr та не повертають потрібний об’єкт headers. Без розширення контракту parser вони для цієї реалізації не підходять.
На цьому місці я спочатку хотів залишити сторонній endpoint постійною частиною конвеєра, але це не наш метод. Чужий сервіс може змінити формат відповіді, застосувати rate limit, тимчасово впасти або заблокувати частину проксі як підозрілий трафік. Для production правильніше підняти власний мінімальний HTTPS echo endpoint на публічному VPS і виконувати дві окремі перевірки: локальну — для протоколу та маршруту всередині стенда, публічну — для реального internet egress, зовнішньої IP-адреси й ASN. Поточний validator приймає лише один ANONYMITY_CHECK_URL, тому одночасний двоетапний тест лишається наступним удосконаленням.
Python-код
async def guarded(candidate: ProxyCandidate):
    async with semaphore:
        return await probe(
            candidate,
            target,
            direct_identities,
            timeout,
        )

checked = await asyncio.gather(
    *(guarded(candidate) for candidate in candidates)
)
asyncio тут природно підходить до задачі: більшість часу процес не рахує, а чекає socket, TLS handshake або відповідь сервера. Semaphore не дозволяє одночасно відкрити більше з'єднань, ніж указано в VALIDATION_CONCURRENCY.
У моєму стенді це значення дорівнює 100:
Показати код
VALIDATION_CONCURRENCY=100
PROXY_VALIDATION_TIMEOUT_SECONDS=8
Важливе обмеження поточної версії: semaphore обмежує мережеву конкуренцію, але gather() все одно створює coroutine для кожного кандидата. Для сотень і тисяч адрес цього достатньо. Перед запуском на сотнях тисяч я заміню цю частину на bounded queue або пакетну обробку, щоб обмежити ще й використання пам'яті.
Перевірка authenticated proxy
Credentials дістаються безпосередньо перед handshake:
Python-код
auth = credentials.get(candidate.credential_ref)
observation, latency_ms = await proxy_observation(
    candidate,
    target,
    timeout,
    auth,
)
У snapshot і логах лишається тільки credential_ref. Якщо посилання не знайдене, файл не читається або proxy відхиляє пароль, кандидат не потрапляє у validated pool. Зараз для HTTP(S) реалізовано Basic auth; схеми Digest, NTLM і Negotiate потребуватимуть окремих adapter.
Як визначається анонімність
Класифікація навмисно проста:
Python-код
if observation.peer in direct_identities:
    return None

for name in LEAK_HEADERS:
    if any(ip in observation.headers.get(name, "")
           for ip in direct_identities):
        return None

return (
    "anonymous"
    if PROXY_MARKER_HEADERS.intersection(observation.headers)
    else "elite"
)
Якщо endpoint бачить пряму адресу validator або вона з'являється у forwarding headers, кандидат відхиляється. Заголовок Via сам по собі не розкриває IP клієнта: такий проксі приймається з рівнем anonymous. Якщо немає ні витоку, ні proxy marker — запис отримує рівень elite.
Echo endpoint входить у trust boundary системи. Сторонній сервіс бачитиме всі перевірені вихідні адреси, тому в проєкті є свій невеликий test-echo.py. Для production я так само використовував би власний endpoint із мінімальними логами та rate limit.
Після перевірки запис виглядає приблизно так:
JSON
{
  "host": "192.0.2.10",
  "port": 1080,
  "protocol": "socks5",
  "source": "provider-api",
  "credential_ref": "provider-a",
  "exit_ip": "203.0.113.18",
  "metadata": {
    "source_asn": "AS64499"
  },
  "network": {
    "asn_status": "verified",
    "asn": "AS64500",
    "organization": "Example Network",
    "prefix": "203.0.113.0/24"
  },
  "latency_ms": 184,
  "anonymous": true,
  "anonymity_level": "elite",
  "success_streak": 4
}
Увесь перевірений snapshot публікується в:
Показати код
proxy_pool:validated:v1
Звідки береться ASN
ASN із feed не можна вважати надійним: він може бути застарілим, підробленим або описувати адресу proxy endpoint, тоді як трафік виходить через іншу мережу.
Джерелом істини має бути IP-адреса, яку фактично побачив публічний echo endpoint. Після успішної перевірки validator бере observation.peer і виконує lookup у локальній origin-asn.mmdb:
Python-код
snapshot["exit_ip"] = observation.peer
snapshot["network"] = asn_resolver.resolve(
    observation.peer
)
Якщо перевірка спрямована на локальний 10.10.10.2:8000, observation.peer містить приватну адресу контейнера. Це корисно для підтвердження маршруту в лабораторії, але така адреса не дає змістовного ASN і не підтверджує мережеву різноманітність публічних виходів. Для повноцінного ASN-скорингу target повинен бути публічним і контрольованим нами.
Окремий asn-updater завантажує щоденний PDDL-реліз ip-location-db, звіряє опублікований SHA-256 і атомарно замінює MMDB. Зовнішнього API-запиту для кожної адреси немає. Якщо база відсутня, пошкоджена або старша за ASN_MAX_DATABASE_AGE_SECONDS, validator не публікує новий snapshot і залишає попередній робочий пул.
ASN від connector не викидається повністю: поле перейменовується на source_asn і лишається для діагностики. Ranker читає тільки перевірений network.asn. Кандидати, для яких локальна база не знайшла ASN, отримують штраф, а їх частка в active pool обмежується MAX_UNKNOWN_ASN_RATIO.
Ранжування проксі: швидкий — ще не означає найкращий
Після базового фільтра лишається набір робочих проксі. Тепер їх треба впорядкувати.
Поточна функція score враховує затримку та серію успішних перевірок:
Python-код
def base_score(entry):
    latency_ms = max(1, int(entry.get("latency_ms", 1)))
    success_streak = max(1, int(entry.get("success_streak", 1)))

    latency_component = 1000.0 / (1.0 + latency_ms)
    stability_component = min(success_streak, 10) * 2.0

    return latency_component + stability_component
Стабільність тут — це кількість послідовних успішних циклів validator. Бонус обмежений десятьма перевірками, щоб старий стабільний проксі не залишався нагорі вічно лише завдяки історії.
Це проста початкова формула. Її коефіцієнти потрібно налаштовувати за власними вимірюваннями. Наприклад, для масового короткого HTTP-трафіку latency може бути важливішою, а для довгих сесій — стабільність.
ASN і subnet diversity
Якщо просто відсортувати список за latency, перші двадцять адрес можуть належати одному провайдеру й навіть одній /24 підмережі. Формально проксі різні, але відмова або блокування одного сегмента прибере відразу значну частину пулу.
Тому ranker працює жадібно. На кожному кроці бере найбільший adjusted score й штрафує повтори вже вибраних ASN і subnet:
Python-код
diversity_penalty = 1.0

if candidate_asn:
    diversity_penalty += asn_counts[candidate_asn]

if candidate_subnet:
    diversity_penalty += subnet_counts[candidate_subnet]

score = base_score(entry) / diversity_penalty
Наприклад, у тесті є два швидкі проксі з AS1 і один трохи повільніший з AS2. Результат такий:
Показати код
10.0.0.1:3128  AS1
10.0.1.1:3128  AS2
10.0.0.2:3128  AS1
Другий запис з AS1 не видаляється, але опускається нижче. У reserve він лишиться й зможе повернутися в роботу, якщо кращі кандидати відпадуть.
Не «взяти 150», а пройти поріг якості
Спочатку я хотів просто брати перші 150 адрес. Потім зрозумів, що фіксоване число непомітно перетворюється на ціль.
Якщо хороших проксі лише 43, система не повинна підтягувати ще 107 повільних тільки тому, що в .env написано 150. Якщо хороших адрес 500, немає сенсу навантажувати gateway усіма одночасно.
Тому в конфігурації є три різні поняття:
Показати код
MIN_SCORE_THRESHOLD=18
POOL_SIZE=150
RESERVE_SIZE=700
MIN_SCORE_THRESHOLDвизначає мінімальну якість;POOL_SIZEзадає верхню межу активного пулу;RESERVE_SIZEобмежує розмір відсортованого резерву.
Ranker спочатку відкидає все нижче порога, потім формує reserve і лише після цього бере верхню частину в active:
Python-код
ranked = rank_entries(
    entries,
    reserve_size=reserve_size,
    min_score=min_score,
)

active = ranked[:pool_size]
Отже POOL_SIZE=150 означає «не більше 150», а не «добрати будь-якою ціною до 150».
У майбутньому тут легко зробити кілька профілів: невеликий high-quality для чутливих сценаріїв і більший bulk для масових задач. Але в поточній реалізації публікується один active pool, тому кілька профілів поки що лишаються наступним кроком, а не прихованою готовою функцією.
Атомарна публікація без гонки читача й процесу запису
Validator і ranker працюють незалежно. Один процес може записувати новий snapshot саме тоді, коли інший його читає.
Перший варіант — записувати великий JSON одразу в бойовий ключ — створює гонку: читач може звернутися до Redis саме під час оновлення. Тому кожна стадія спочатку створює тимчасовий ключ, а потім атомарно перейменовує його:
Python-код
async def publish_snapshot(client, key, snapshot):
    temporary_key = f"{key}:tmp:{uuid.uuid4().hex}"
    encoded = json.dumps(
        snapshot,
        separators=(",", ":"),
        sort_keys=True,
    )
    await client.set(temporary_key, encoded)
    await client.rename(temporary_key, key)
Redis RENAME замінює ключ однією операцією. Читач бачить або старий повний snapshot, або новий повний snapshot — проміжного стану немає.
Конвеєр використовує такі ключі:
Показати код
proxy_pool:raw:v1
proxy_pool:validated:v1
proxy_pool:reserve:v1
proxy_pool:active:v1
transparent-gateway:validated:v1
Останній — compatibility key, який уже читає gateway.
Хто насправді застосовує active pool
Спочатку я хотів залишити HAProxy єдиним споживачем active pool: згенерувати haproxy.cfg, перевірити його через haproxy -c і виконати reload або керувати server templates через Runtime API. Для однорідного пулу HTTP-проксі це працює, як показав лабораторний стенд із вісьмома LXC.
Глухий кут з’явився, коли до пулу потрапили HTTP, HTTPS, SOCKS4 і SOCKS5, іноді ще й із credentials. Звичайний TCP backend HAProxy не виконає SOCKS handshake і не дістане пароль за credential_ref. Отже, конфігураційного adapter для HAProxy недостатньо: між redsocks і upstream потрібен компонент, який розуміє протокол.
Тому в поточній робочій версії між redsocks і upstream з'явився protocol-aware egress_relay:
Показати код
VM
  → iptables
  → redsocks :12345
  → egress_relay :12000
  → HTTP / HTTPS / SOCKS4 / SOCKS5 upstream
  → destination
Перед вибором upstream для нового з’єднання relay перевіряє active snapshot у Redis, але робить це не частіше ніж раз на три секунди. Потім він вибирає кандидата, виконує потрібний proxy handshake і підставляє credentials лише в момент з’єднання.
Python-код
if time.monotonic() - self.last_refresh >= 3:
    raw = await client.get(
        "transparent-gateway:validated:v1"
    )
    self.entries = json.loads(raw)["entries"][:self.size]
Це й дає оновлення без restart або reload. HAProxy лишається корисним для однорідних пулів і лабораторної перевірки балансування, але стверджувати, що поточний ranker уже перегенеровує його backend, було б неправильно. Окремий HAProxy adapter можна додати як ще одного споживача proxy_pool:active:v1.
Повна схема конвеєра
Система не передає в gateway перший-ліпший список проксі. Кожен кандидат проходить кілька окремих етапів: спочатку його збирають, потім перевіряють, оцінюють і лише після цього додають до робочого пулу.
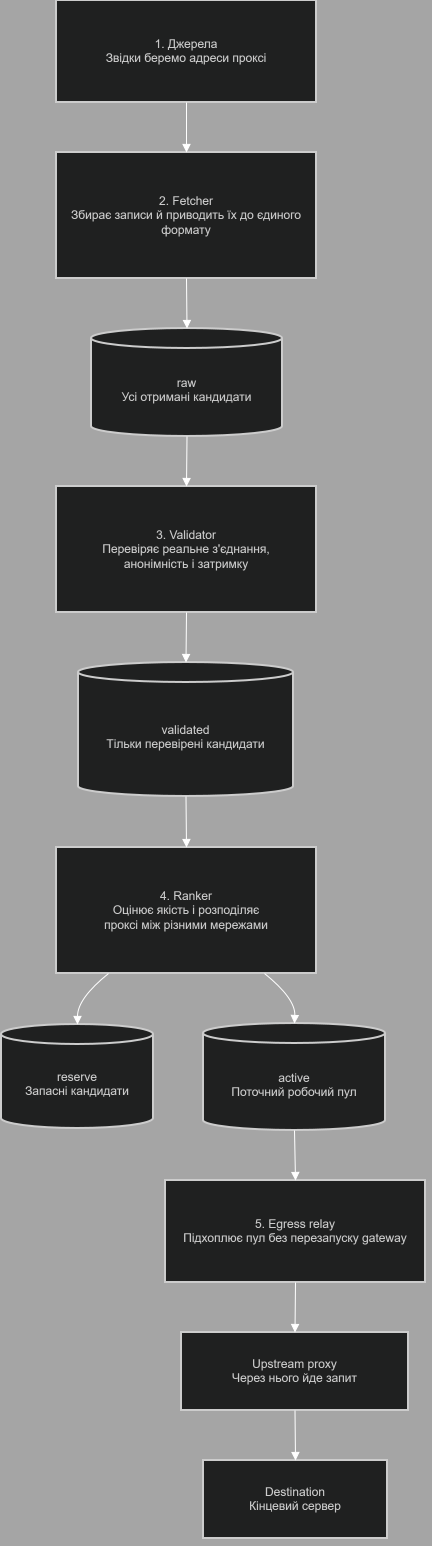
Якщо джерело тимчасово недоступне, це не зупиняє весь конвеєр. Якщо окремий проксі перестає працювати, validator прибирає його з перевіреного списку, а ranker може замінити його кандидатом із reserve. Gateway при цьому продовжує працювати й підхоплює оновлений active pool із Redis.
Кожна стадія читає повний snapshot, робить одну зрозумілу операцію й атомарно публікує наступний. Модулі не викликають один одного напряму, тому fetcher можна оновити, не зупиняючи validator або gateway.
Практична перевірка
Починаю з unit-тестів connector, authenticated protocol probe, ASN resolver, atomic snapshot і ranker. Вони ізолюють протокольні сценарії, які незручно й небезпечно відтворювати на випадкових зовнішніх проксі.
Bash-код
python3 -m venv .venv
. .venv/bin/activate
python -m pip install -r requirements-dev.txt
python -m pytest -q
Поточний результат:
Показати код
............................                                             [100%]
28 passed
Після unit-тестів запускаю Redis, fetcher, validator, ranker і gateway. Тут проблема вже інша: окремий модуль може бути справним, але весь ланцюжок не зійдеться через конфігурацію, залежність або відсутній snapshot.
Bash-код
docker compose up -d redis fetcher validator ranker gateway
docker compose ps
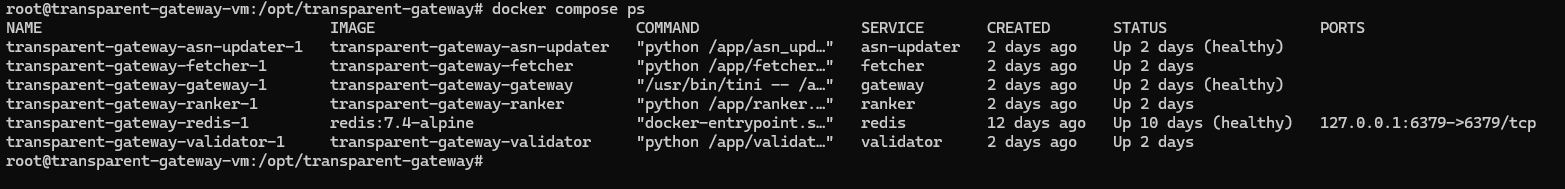
На стенді всі шість сервісів запущені, а Redis, gateway та ASN updater мають статус healthy. Це перевірка готовності компонентів, але ще не доказ проходження кандидата через увесь pipeline.
Щоб не запускати другі екземпляри worker паралельно зі штатними процесами, для smoke check беру останні завершені повідомлення кожної стадії з Compose logs:
Bash-код
docker compose logs --no-log-prefix --tail=20 fetcher validator ranker
Показати код
[fetcher] sources=1 candidates=1
[validator] healthy=1/1
[ranker] validated=1 reserve=1 active=1
Ці три рядки показують останні успішно завершені цикли: fetcher отримав одного кандидата, validator визнав його робочим, а ranker опублікував по одному запису в reserve та active. Це компактний smoke check стану конвеєра, а не доказ, що три повідомлення належать одній розподіленій транзакції. Поточний стенд використовує один агрегований HAProxy endpoint; авторизовані HTTP, CONNECT, SOCKS4 і SOCKS5 сценарії перевіряються окремими unit-тестами.
Тест 1. Цілісність snapshot-ланцюжка
Спочатку я хотів показати красиве зменшення кількості від raw до active. Але з одним здоровим кандидатом цифри закономірно лишилися 1 → 1 → 1 → 1. Цей вивід підтверджує, що всі snapshot-ключі заповнені повними списками. Причинний зв’язок і свіжість циклів окремо перевіряються за generated_at, source_generated_at та логами worker.
Bash-код
./scripts/run-redis-rows.sh
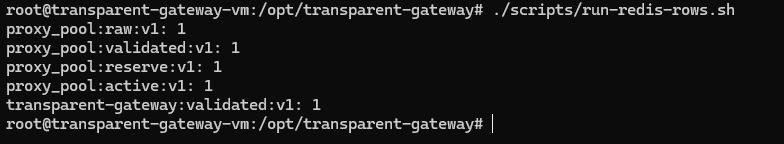
Дедуплікацію та відмову окремого джерела перевіряю контрольованим тестом: дубль має потрапити в raw один раз, а некоректний JSON одного connector не повинен зупиняти решту. У логах при цьому не можна показувати token або credentials.
Тест 2. Відсів витоку адреси
Перевірка відкритого порту завела б у хибний позитивний результат: proxy може прийняти TCP-з’єднання й водночас розкрити адресу validator. Тому контрольований echo endpoint імітує три випадки:
- X-Forwarded-For містить пряму адресу клієнта;
- Via присутній, але direct IP не витікає;
- немає ні витоку, ні proxy marker.
Очікуваний результат:
Показати код
X-Forwarded-For з direct IP → reject
Via без direct IP             → anonymous
без витоку й marker           → elite
Цей тест важливіший за nc -z: він перевіряє властивість, заради якої кандидат узагалі потрапляє в пул.
Тест 3. Ранжування й ASN diversity
Сортування лише за latency знову приводить у глухий кут: два найшвидші кандидати можуть належати одному ASN і одній підмережі. Для контрольованого тесту беру два швидкі записи з AS1 і трохи повільніший запис з AS2.
Показати код
INPUT
proxy-1: ASN=AS1, latency=10ms
proxy-2: ASN=AS1, latency=11ms
proxy-3: ASN=AS2, latency=20ms

OUTPUT
1. proxy-1: ASN=AS1, latency=10ms, score=92.909091
2. proxy-3: ASN=AS2, latency=20ms, score=49.619048
3. proxy-2: ASN=AS1, latency=11ms, score=28.444444
Після спільного ASN/subnet penalty кандидат з AS2 піднімається між двома записами AS1. Це синтетичний виклик rank_entries() із документаційними адресами: він показує порядок ранжування, але не перевіряє MMDB і не змінює production snapshot у Redis.
Тест 4. Поріг якості
Ще одна пастка — сприймати POOL_SIZE як план, який треба виконати будь-якою ціною. Порівнюю ranker із двома значеннями порога:
Показати код
MIN_SCORE_THRESHOLD=0
MIN_SCORE_THRESHOLD=18
Після підвищення порога reserve й active можуть стати меншими за POOL_SIZE. Це очікувана поведінка: порожнє місце в пулі краще за кандидат, який не проходить мінімальну якість.
Тест 5. Оновлення без рестарту
Потрібно відрізнити атомарну заміну даних від перезапуску процесу. У контрольованій перевірці той самий active snapshot отримує новий generated_at, після чого порівнюються кількість entries і StartedAt контейнера gateway:
Показати код
snapshot generated before: 1787981367
snapshot generated after:  1787981375
active entries before: 1
active entries after:  1
gateway started before: 2026-08-26T12:56:50.726245488Z
gateway started after:  2026-08-26T12:56:50.726245488Z
gateway restarted: no
Вивід підтверджує дві речі: Redis отримав повний новий snapshot, а контейнер gateway не перезапускався. Він не доводить, що egress_relay уже використав новий склад пулу: для цього потрібні різні entries до й після та нове з’єднання через relay.
Тест 6. Відмова upstream і межі стенда
Тут я спочатку хотів показати cooldown усередині egress_relay. Але active snapshot містив лише один агрегований endpoint HAProxy, тому relay фізично не мав другого direct candidate для переходу. Замість удаваної демонстрації я повернувся до стенда з попередньої статті: вісім LXC-проксі за HAProxy та внутрішній echo server.
Один backend уже недоступний, HAProxy позначає його DOWN і не віддає йому нові з’єднання. Десять свіжих запитів мають пройти через сім робочих LXC:
Bash-код
./scripts/run-upstream-failure-test.sh
Показати код
=== HAPROXY DOWN-BACKEND CHECK ===
HAProxy backend status:
test1: DOWN
test2: UP
test3: UP
test4: UP
test5: UP
test6: UP
test7: UP
test8: UP
BACKEND: UP

Ten fresh requests to the internal echo server:
request-01: HTTP 200 backend_peer=10.10.10.14
request-02: HTTP 200 backend_peer=10.10.10.15
request-03: HTTP 200 backend_peer=10.10.10.16
request-04: HTTP 200 backend_peer=10.10.10.17
request-05: HTTP 200 backend_peer=10.10.10.18
request-06: HTTP 200 backend_peer=10.10.10.12
request-07: HTTP 200 backend_peer=10.10.10.13
request-08: HTTP 200 backend_peer=10.10.10.14
request-09: HTTP 200 backend_peer=10.10.10.15
request-10: HTTP 200 backend_peer=10.10.10.16
Усі десять запитів повернули HTTP 200, а backend_peer змінювався між доступними адресами. Цей результат підтверджує HAProxy health check і end-to-end доступ до echo server, але не є доказом cooldown у egress_relay. Relay cooldown покритий тестами; для живої демонстрації в active pool потрібні щонайменше два direct candidates.
Що вже працює, а що ще треба доробити
На цьому етапі вже працюють:
- явний registry джерел;
- JSONL та HTTPS JSON connector;
- дедуплікація кандидатів;
- реальна перевірка HTTP/HTTPS/SOCKS4/SOCKS5;
- authenticated proxy через
credential_refбез secrets у Redis; - відсів витоку direct IP;
- latency та
success_streak; - локальний ASN lookup за адресою, яку побачив echo endpoint; приватні адреси коректно отримують статус
unknown; - checksum-verified ASN updater;
- ASN/subnet-aware ranking;
- quality threshold, reserve й active pool;
- атомарні Redis snapshot;
- підхоплення нового active pool у gateway без рестарту.
Перед великим production-пулом я ще хочу додати:
- bounded worker queue для дуже великих списків;
- кілька профілів пулу під різні задачі;
- метрики циклів, причин reject і віку snapshot;
- окремий HAProxy adapter для однорідних backend, якщо він знадобиться;
- захист від одночасного запуску двох екземплярів одного worker через distributed lock або leader election.
Останній пункт важливий: атомарний RENAME захищає читача від часткового JSON, але не вирішує конфлікт двох повноцінних процесів запису. Для одного екземпляра кожного сервісу Compose цього достатньо; при горизонтальному масштабуванні потрібна окрема координація.
Висновок
Сам конвеєр більше не потребує ручного перенесення кандидатів між стадіями: fetcher збирає їх із явно підключених джерел, validator перевіряє проходження трафіку й анонімність, ranker формує reserve та active, а gateway читає active snapshot без рестарту. У показаному лабораторному стенді active pool поки містить один агрегований HAProxy endpoint; різноманітність реальних публічних виходів потребує direct candidates і власного публічного echo endpoint.
Найкориснішою для мене виявилась не окрема формула score, а саме розділення системи на snapshot-стадії. Джерело може зникнути, один цикл може не знайти жодного нового кандидата, а proxy може померти між двома перевірками — кожен із цих випадків тепер має зрозуміле місце в конвеєрі.
Наступний крок — перестати лікувати все це вручну на одному Debian-хості. У наступній частині проведу аудит поточного gateway: розберу, чому робоча VM ще не є відтворюваним deployment, де закінчується cloud-init і що потрібно змінити перед production.
Код проєкту: TransparentGateway на GitHub